---
title: "¿Cuál de estos dos procedimientos es más exacto?"
subtitle: "Dos procedimientos. Uno tiene menor sesgo. El otro, mejor precisión. ¿Cuál es más exacto?"
author: "Carlos Gómez"
date: "2026-10-07"
lang: es
format:
html:
toc: true
toc-depth: 3
code-fold: true
code-tools: true
code-copy: true
fig-responsive: true
number-sections: false
execute:
echo: true
warning: false
message: false
bibliography: references.bib
csl: numeric.csl
image: imagen_inicial.png
---
```{r}
#| label: setup
#| include: false
library(ggplot2)
set.seed(20261007)
theta <- 100 # mg/kg, valor de referencia del ejemplo
colores_proc <- c("A" = "#0e61fe", "B" = "#E76F51")
procedimientos <- data.frame(
procedimiento = c("A", "B"),
media = c(100, 101),
sd = c(5, 0.5)
)
n_sim <- 5000
datos <- rbind(
data.frame(
procedimiento = "A",
resultado = rnorm(n_sim, mean = procedimientos$media[1], sd = procedimientos$sd[1])
),
data.frame(
procedimiento = "B",
resultado = rnorm(n_sim, mean = procedimientos$media[2], sd = procedimientos$sd[2])
)
)
datos$procedimiento <- factor(datos$procedimiento, levels = c("A", "B"))
procedimientos$sesgo <- procedimientos$media - theta
procedimientos$sesgo_abs <- abs(procedimientos$sesgo)
procedimientos$varianza <- procedimientos$sd^2
procedimientos$mse <- procedimientos$sesgo^2 + procedimientos$varianza
procedimientos$rmse <- sqrt(procedimientos$mse)
fmt <- function(x, digits = 2) format(round(x, digits), nsmall = digits, decimal.mark = ",")
tema_analytical <- theme_minimal(base_family = "sans", base_size = 14) +
theme(
panel.grid.minor = element_blank(),
plot.title = element_text(face = "bold", size = 17),
plot.subtitle = element_text(size = 12),
axis.title = element_text(face = "bold"),
legend.position = "top",
legend.title = element_blank()
)
```
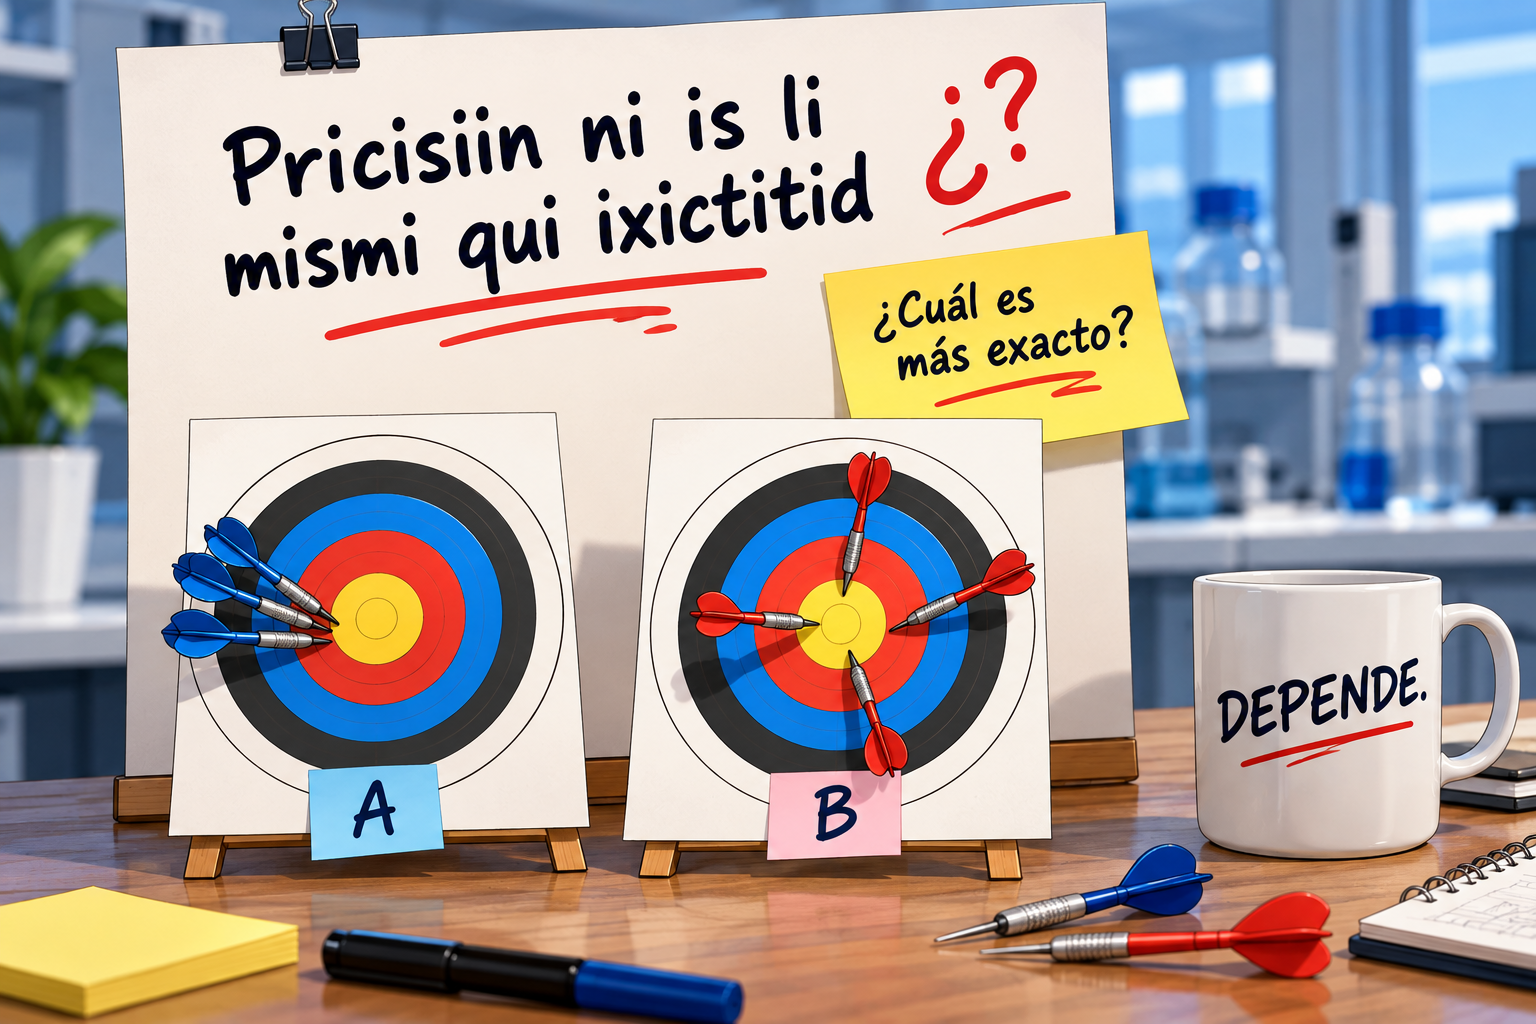
Hay una imagen que aparece una y otra vez cuando se explica exactitud y precisión: varios conjuntos de puntos alrededor de un valor objetivo. Sirve para introducir la diferencia entre veracidad y precisión.
Ya lo has visto un millón de veces.
El típico de post de Linkedin "Precisión ≠ Exactitud"
::: aside
«Pricisiin ni is li mismi qui ixictitid»
-- Grandhi
:::
Pero deja en el aire una pregunta bastante más incómoda.
Supongamos una situación bastante familiar en química analítica. Estás evaluando dos procedimientos para determinar la concentración de un analito en un material de referencia cuyo valor asignado es **100 mg/kg**. Después de un estudio adecuado del desempeño obtienes, de manera simplificada, lo siguiente:
- El **procedimiento A** entrega, en promedio, 100 mg/kg: su sesgo es 0 mg/kg. Sin embargo, los resultados individuales presentan una desviación estándar de 5 mg/kg.
- El **procedimiento B** entrega, en promedio, 101 mg/kg: tiene un sesgo de +1 mg/kg. Pero sus resultados son mucho más consistentes, con una desviación estándar de apenas 0,5 mg/kg.
A tiene mejor veracidad. B tiene mucho mejor precisión.
**¿Cuál de los dos es más exacto?**
La pregunta parece sencilla... hasta que intentas responderla.
# Primero, miremos los resultados
Para aterrizar el problema, simularemos resultados de ambos procedimientos. No pretendo reproducir un método analítico concreto: el ejemplo está deliberadamente **sobre-simplifcado** para aislar el típico "conflicto" entre sesgo y variabilidad (precisión).
```{r}
#| label: fig-distribuciones
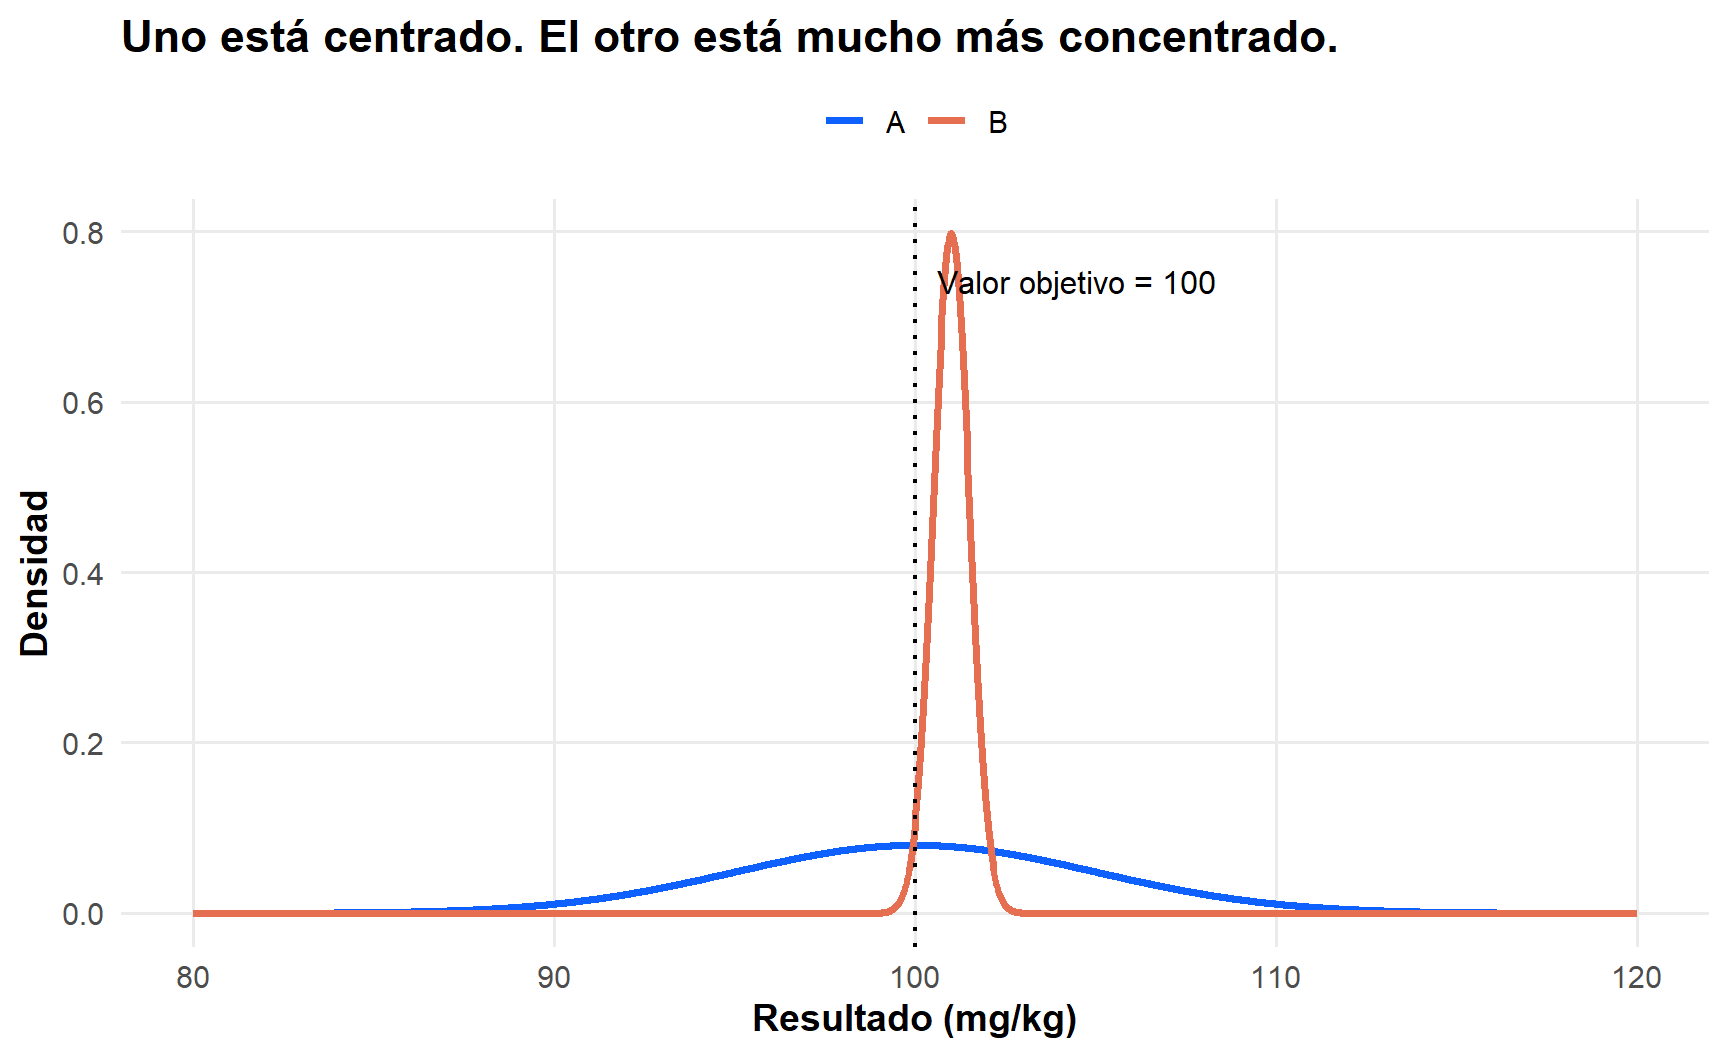
#| fig-cap: "Distribuciones teóricas de resultados para los procedimientos A y B. La línea vertical representa el valor objetivo."
#| fig-width: 9
#| fig-height: 5.5
x <- seq(80, 120, length.out = 1500)

dens <- rbind(
  data.frame(
    resultado = x,
    densidad = dnorm(x, mean = 100, sd = 5),
    procedimiento = "A"
  ),
  data.frame(
    resultado = x,
    densidad = dnorm(x, mean = 101, sd = 0.5),
    procedimiento = "B"
  )
)

ggplot(dens, aes(resultado, densidad, color = procedimiento)) +
  geom_line(linewidth = 1.25) +
  scale_color_manual(values = colores_proc) +
  geom_vline(xintercept = theta, linewidth = 0.8, linetype = 3) +
  annotate("text", x = theta, y = max(dens$densidad) * 0.93,
           label = "Valor objetivo = 100", hjust = -0.08, size = 4.2) +
  labs(
    title = "Uno está centrado. El otro está mucho más concentrado.",
    x = "Resultado (mg/kg)",
    y = "Densidad",
    color = NULL
  ) +
  tema_analytical
```
El procedimiento A produce resultados muy dispersos alrededor de 100. El procedimiento B produce resultados mucho más *concentrados*, pero alrededor de 101.
Si miramos solamente el promedio, A parece preferible. Si miramos solamente la dispersión, B parece preferible.
Y ése es precisamente el problema.
```{r}
#| label: fig-muestras
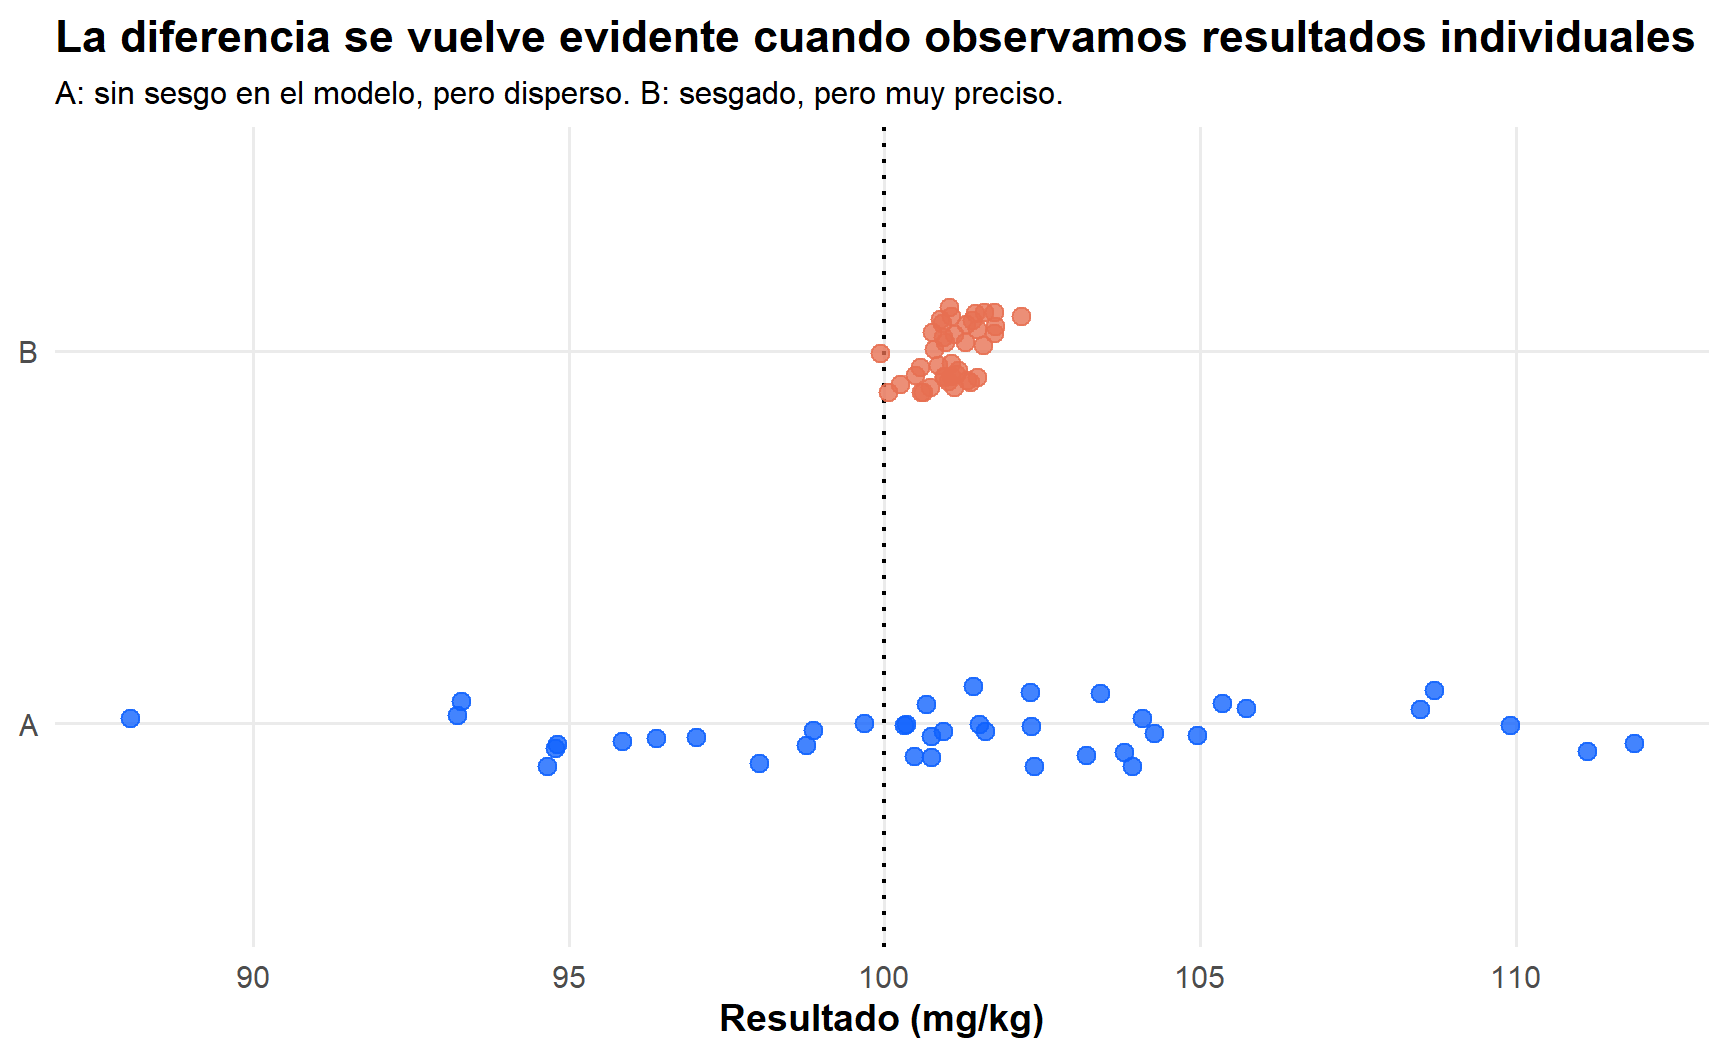
#| fig-cap: "Una realización simulada de 40 resultados de cada procedimiento."
#| fig-width: 9
#| fig-height: 5.5
set.seed(20261007)

muestra <- rbind(
  data.frame(procedimiento = "A", resultado = rnorm(40, 100, 5)),
  data.frame(procedimiento = "B", resultado = rnorm(40, 101, 0.5))
)

muestra$procedimiento <- factor(muestra$procedimiento, levels = c("A", "B"))

muestra$orden <- ave(seq_len(nrow(muestra)), muestra$procedimiento, FUN = seq_along)

ggplot(muestra, aes(resultado, procedimiento, color = procedimiento)) +
  geom_vline(xintercept = theta, linewidth = 0.8, linetype = 3) +
  geom_point(position = position_jitter(height = 0.12, width = 0), alpha = 0.78, size = 2.9) +
  scale_color_manual(values = colores_proc, guide = "none") +
  labs(
    title = "La diferencia se vuelve evidente cuando observamos resultados individuales",
    subtitle = "A: sin sesgo en el modelo, pero disperso. B: sesgado, pero muy preciso.",
    x = "Resultado (mg/kg)",
    y = NULL
  ) +
  tema_analytical
```
# Veracidad y precisión no son lo mismo
Antes de escribir una ecuación, pensemos en lo que significan estos dos comportamientos en el laboratorio.
Un procedimiento puede entregar un promedio muy próximo al valor de referencia y, aun así, producir resultados individuales bastante dispersos. Eso podría ocurrir, por ejemplo, porque etapas como pesada, extracción, dilución, inyección o control de temperatura introducen variabilidad entre determinaciones. El promedio puede estar bien situado, pero cada nueva determinación tiene bastante espacio para moverse.
También puede ocurrir lo contrario. Un procedimiento puede ser extraordinariamente repetible y, sin embargo, desplazar sistemáticamente los resultados. Una extracción incompleta, una interferencia de matriz o una calibración que introduce un sesgo pueden producir resultados muy agrupados... alrededor del lugar equivocado. ISO 5725-4 menciona precisamente ejemplos químicos como una extracción incompleta o la interferencia de otro elemento como posibles orígenes de sesgo [@ISO5725-4-2020].
Eso es lo que hemos construido deliberadamente con A y B. **A está mejor situado respecto del valor de referencia; B produce resultados mucho menos dispersos.**
Ahora sí podemos traducir esa idea a un modelo estadístico muy sencillo. Representemos un resultado individual obtenido en el laboratorio como:
$$
X = \theta + b + \varepsilon,
$$
donde $\theta$ es el valor de referencia (a.k.a *verdadero*), $b$ representa un sesgo respecto de ese valor y $\varepsilon$ recoge la variación aleatoria entre determinaciones (*repetibilidad)*. Si esta variación aleatoria tiene promedio cero y desviación estándar $\sigma$, entonces
$$
\operatorname{Bias}(X)=E(X)-\theta=b,
$$
y su dispersión queda caracterizada, en este modelo, por
$$
\operatorname{Var}(X)=\sigma^2.
$$
La notación solo resume dos cosas que nos interesan: dónde se centran los resultados y cuánto varían... tu sabes, a los Estadísticos les encanta escribir en griego. Para lo que sigue basta con recordar dos cosas: **$b$ nos dice cuánto se aparta el centro de los resultados del valor de referencia y $\sigma$ cuánto varían las determinaciones entre sí.**
ISO 5725-1 utiliza **accuracy** como término general referido conjuntamente a *trueness* y *precision* [@ISO5725-1-2023]. La veracidad se relaciona con el error sistemático y se estudia habitualmente mediante el sesgo; la precisión describe la cercanía entre resultados obtenidos bajo condiciones especificadas [@ISO5725-1-2023; @ISO5725-4-2020].
Para nuestro ejemplo:
```{r}
#| label: tbl-resumen
#| echo: false
resumen <- data.frame(
Procedimiento = procedimientos$procedimiento,
Media = procedimientos$media,
Sesgo = procedimientos$sesgo,
`Desviación estándar` = procedimientos$sd,
MSE = procedimientos$mse,
RMSE = procedimientos$rmse,
check.names = FALSE
)
knitr::kable(resumen, digits = 2, align = "c")
```
A es mejor respecto del sesgo. B es mejor respecto de la desviación estándar.
Ninguno es mejor en ambas dimensiones.
# ¿Cómo decidimos cuál de los dos procedimientos es más exacto?
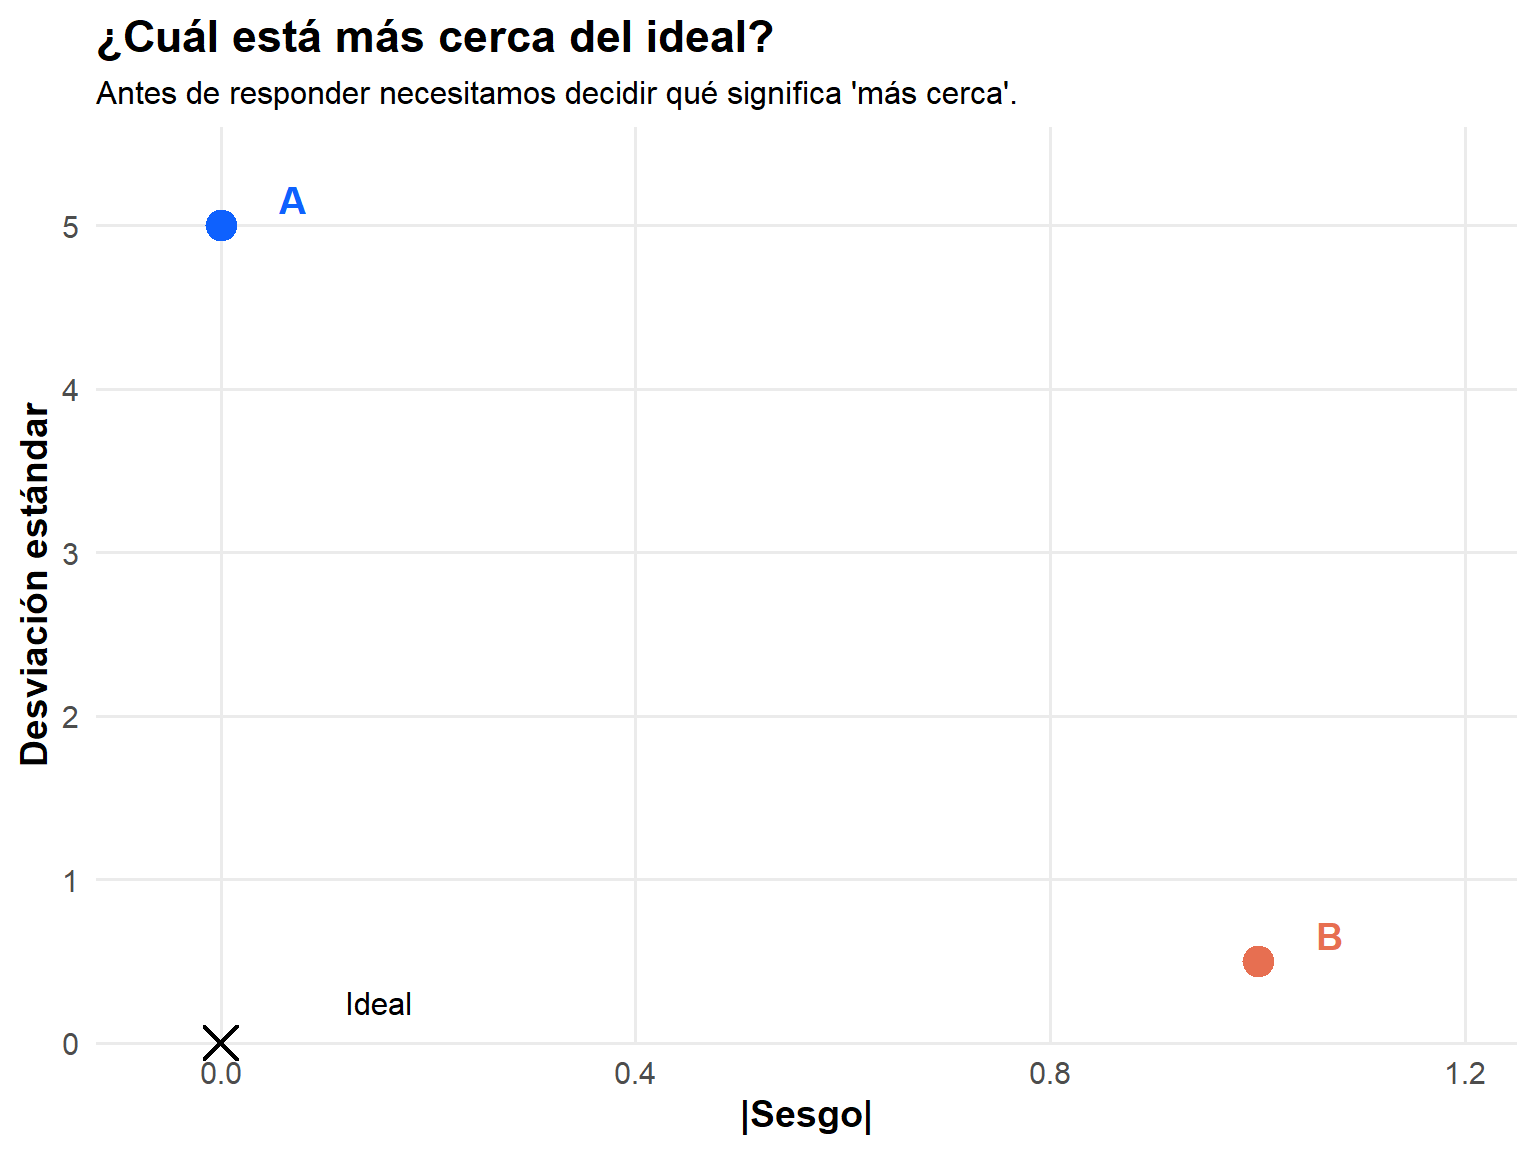
Podemos representar cada procedimiento mediante dos coordenadas:
$$
(|b|,\sigma).
$$
El punto ideal sería $(0,0)$: ningún sesgo y ninguna variabilidad.
```{r}
#| label: fig-sesgo-precision
#| fig-cap: "Desempeño de los dos procedimientos en dos dimensiones: sesgo absoluto y desviación estándar."
#| fig-width: 8
#| fig-height: 6
lim <- 5.6

ggplot(procedimientos, aes(sesgo_abs, sd, label = procedimiento, color = procedimiento)) +
  geom_point(size = 5) +
  scale_color_manual(values = colores_proc, guide = "none") +
  geom_text(nudge_x = 0.07, nudge_y = 0.16, size = 5, fontface = "bold") +
  annotate("point", x = 0, y = 0, shape = 4, size = 5, stroke = 1.2) +
  annotate("text", x = 0.12, y = 0.25, label = "Ideal", hjust = 0, size = 4.2) +
  coord_cartesian(xlim = c(-0.12, 1.25), ylim = c(0, lim), expand = FALSE, clip = "off") +
  labs(
    title = "¿Cuál está más cerca del ideal?",
    subtitle = "Antes de responder necesitamos decidir qué significa 'más cerca'.",
    x = "|Sesgo|",
    y = "Desviación estándar"
  ) +
  tema_analytical
```
Si un procedimiento tuviera simultáneamente menor $|b|$ y menor $\sigma$, la comparación sería sencilla: sería mejor en ambos criterios.
Pero A y B presentan un **trade-off**. A reduce el sesgo a costa de una variabilidad mucho mayor. B hace lo contrario.
Por tanto, conocer $|b|$ y $\sigma$ no produce automáticamente un único orden de "exactitud". Para transformar dos dimensiones en un solo ranking necesitamos introducir una regla adicional.
# Una propuesta estadística para combinar sesgo y precisión: MSE
Hasta aquí tenemos dos números para cada procedimiento. El problema es que apuntan en direcciones distintas.
Para un químico, la pregunta práctica podría formularse así: **si repitiera este procedimiento muchas veces, ¿qué tan lejos quedarían sus resultados del valor de referencia, considerando simultáneamente el sesgo y la dispersión?**
La Estadística tiene una cantidad que puede ayudarnos a responder *esa* pregunta: el **error cuadrático medio**, o MSE por *mean squared error*. No es una definición metrológica de exactitud. Es una propuesta de criterio estadístico para resumir en un solo número dos componentes que hasta ahora hemos mantenido separadas.
La idea es sencilla aunque la ecuación pueda parecer poco amistosa. Para cada resultado calculamos su diferencia respecto del valor de referencia, elevamos esa diferencia al cuadrado y pensamos en el promedio que obtendríamos a lo largo de muchas repeticiones:
$$
\operatorname{MSE}(X)=E[(X-\theta)^2].
$$
¿Por qué elevar al cuadrado? Entre otras cosas, evita que errores positivos y negativos se cancelen y penaliza con mayor fuerza los errores grandes. Pero eso también significa que **estamos escogiendo una manera concreta de valorar los errores**. Volveremos a este punto.
En nuestro modelo, el MSE tiene una propiedad especialmente útil:
$$
\boxed{\operatorname{MSE}=\sigma^2+b^2}
$$
Es decir, reúne la contribución de la variabilidad y la del sesgo en una misma expresión. Si queremos volver a las unidades originales de concentración, tomamos la raíz cuadrada y obtenemos el RMSE:
$$
\boxed{\operatorname{RMSE}=\sqrt{\sigma^2+b^2}}.
$$
Para A:
$$
\operatorname{RMSE}_A=\sqrt{0^2+5^2}=5\ \text{mg/kg}.
$$
Para B:
$$
\operatorname{RMSE}_B=\sqrt{1^2+0.5^2}\approx 1.12\ \text{mg/kg}.
$$
Con este criterio, B queda claramente mejor posicionado: aunque su centro está sesgado en 1 mg/kg, la enorme diferencia de dispersión hace que su error cuadrático esperado sea mucho menor.
Pero la frase correcta es **“B tiene menor RMSE”**, no “hemos demostrado que B es el procedimiento más exacto en cualquier sentido posible”.
>ISO 5725 no define MSE o RMSE como un índice universal de exactitud [@ISO5725-1-2023; @ISO5725-4-2020].
## Ahora que tenemos un criterio, ¿cuándo dos procedimientos serían igualmente exactos?
Estamos usando un criterio prestado de la Estadística, no de la Metrología Química : el MSE combina en un solo número el sesgo y la variabilidad.
Podemos llevar la idea un poco más lejos... ¡y más allá!
Si dos procedimientos tienen el mismo MSE —y, por lo tanto, el mismo RMSE—, este criterio los considera equivalentes, aunque lleguen a ese valor con combinaciones muy distintas de sesgo y precisión.
Por ejemplo, un procedimiento podría tener poco sesgo y mucha dispersión; otro, más sesgo y mucha menos dispersión.
Veámoslo gráficamente.
Si usamos RMSE, todos los pares $(|b|,\sigma)$ que satisfacen
$$
|b|^2+\sigma^2=c^2
$$
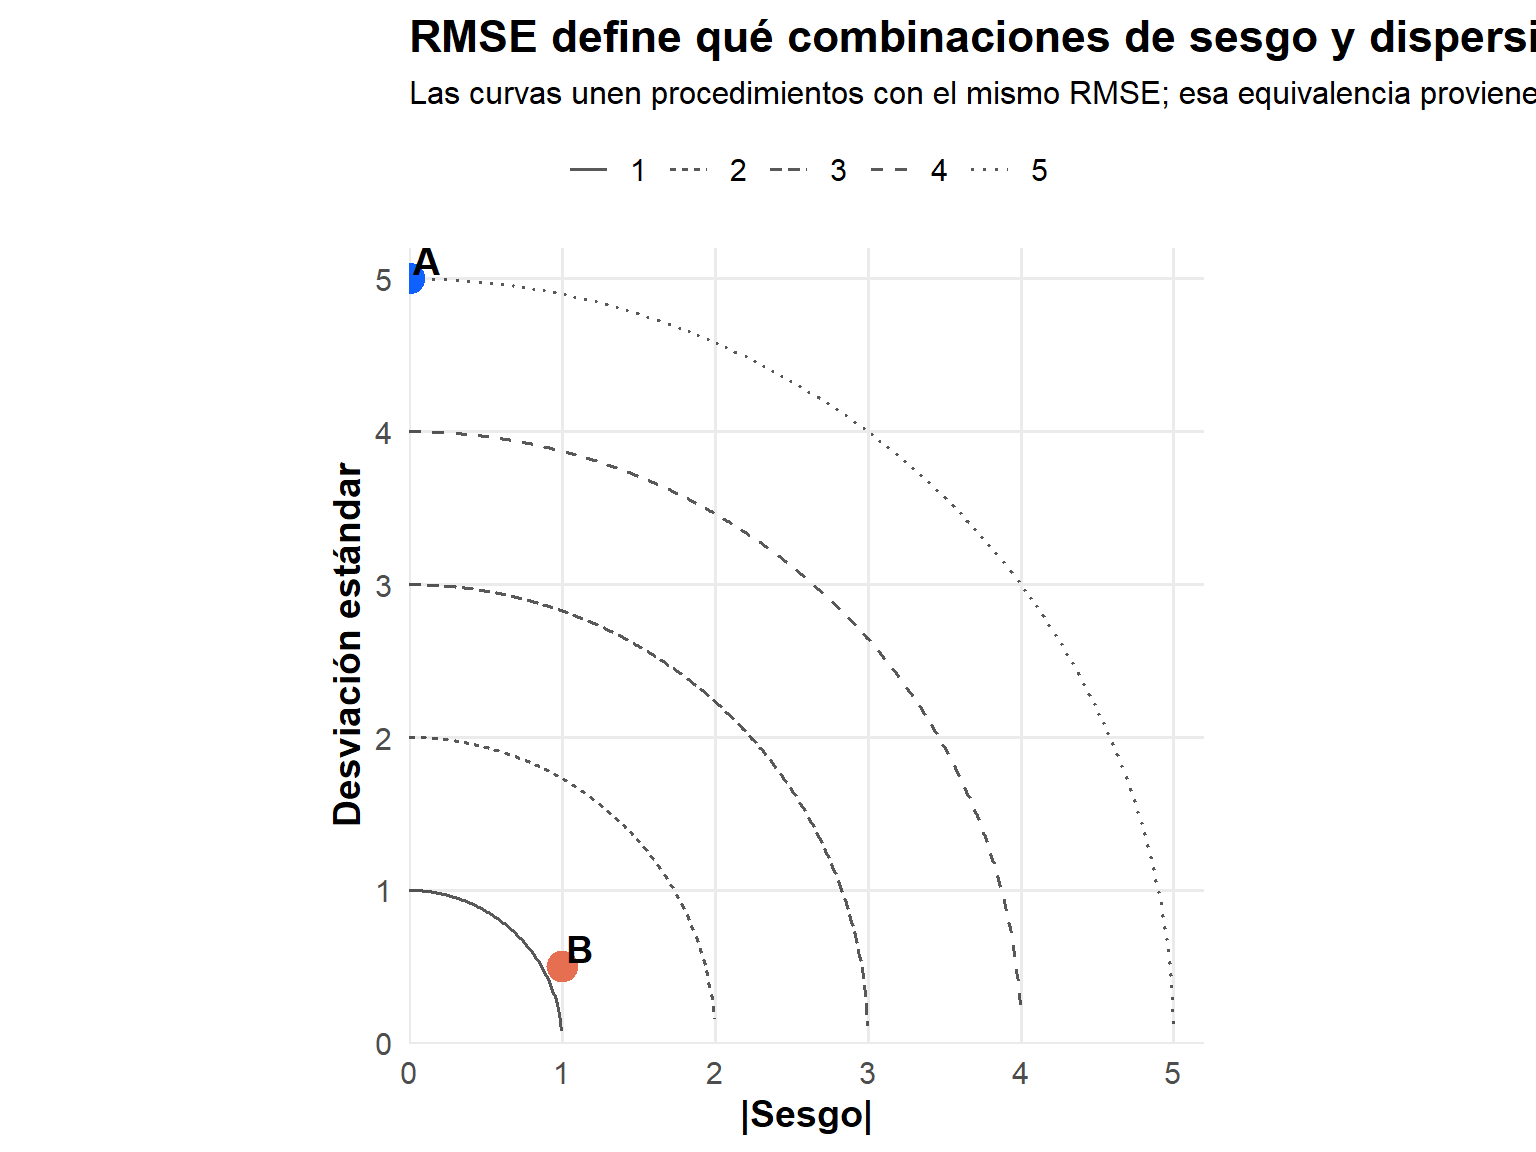
reciben el mismo valor de RMSE $c$. El siguiente gráfico permite ver exactamente qué regla estamos imponiendo.
```{r}
#| label: fig-iso-rmse
#| fig-cap: "Curvas de igual RMSE en el plano |sesgo|–desviación estándar. Usar RMSE define una geometría concreta para comparar procedimientos."
#| fig-width: 8
#| fig-height: 6
sesgo_grid <- seq(0, 5.2, length.out = 700)

niveles <- c(1, 2, 3, 4, 5)

iso <- do.call(rbind, lapply(niveles, function(r) {
  ok <- sesgo_grid <= r
  data.frame(
    sesgo_abs = sesgo_grid[ok],
    sd = sqrt(r^2 - sesgo_grid[ok]^2),
    rmse = factor(r)
  )
}))

ggplot(iso, aes(sesgo_abs, sd, group = rmse, linetype = rmse)) +
  geom_line(linewidth = 0.7, alpha = 0.65) +
  geom_point(data = procedimientos,
             aes(x = sesgo_abs, y = sd, color = procedimiento),
             inherit.aes = FALSE, size = 5) +
  scale_color_manual(values = colores_proc, guide = "none") +
  geom_text(data = procedimientos,
            aes(x = sesgo_abs, y = sd, label = procedimiento),
            inherit.aes = FALSE, nudge_x = 0.12, nudge_y = 0.12,
            size = 5, fontface = "bold") +
  coord_equal(xlim = c(0, 5.2), ylim = c(0, 5.2), expand = FALSE) +
  labs(
    title = "RMSE define qué combinaciones de sesgo y dispersión consideraremos equivalentes",
    subtitle = "Las curvas unen procedimientos con el mismo RMSE; esa equivalencia proviene del criterio elegido.",
    x = "|Sesgo|",
    y = "Desviación estándar",
    linetype = "RMSE"
  ) +
  tema_analytical
```
Geométricamente, RMSE trata $(|b|,\sigma)$ como dos coordenadas y define una distancia al punto ideal $(0,0)$. Eso nos permite ordenar A y B, pero sólo después de haber decidido cómo combinar ambas dimensiones.
# ¿Qué ocurre si el resultado es el promedio de varios replicados?
Hasta ahora hemos comparado resultados individuales. Pero ésa no siempre es la forma en que trabajamos en el laboratorio. Podemos preparar o medir varios replicados y reportar su promedio.
Imaginemos, por ahora, un caso deliberadamente simple: hacemos $n$ determinaciones independientes bajo las mismas condiciones; cada una mantiene el mismo sesgo del procedimiento y la misma desviación estándar; además, suponemos que la variabilidad se comporta aproximadamente como una distribución normal. No estoy diciendo que un método real cumpla automáticamente estas condiciones. Las usamos para aislar qué efecto tiene **promediar replicados**.
En palabras, el modelo dice algo bastante familiar: el promedio de los replicados seguirá centrado en el mismo lugar que los resultados individuales, pero fluctuará menos de un experimento a otro. En notación estadística esto suele escribirse
$$
\bar X_n \sim N\left(\theta+b,\frac{\sigma^2}{n}\right),
$$
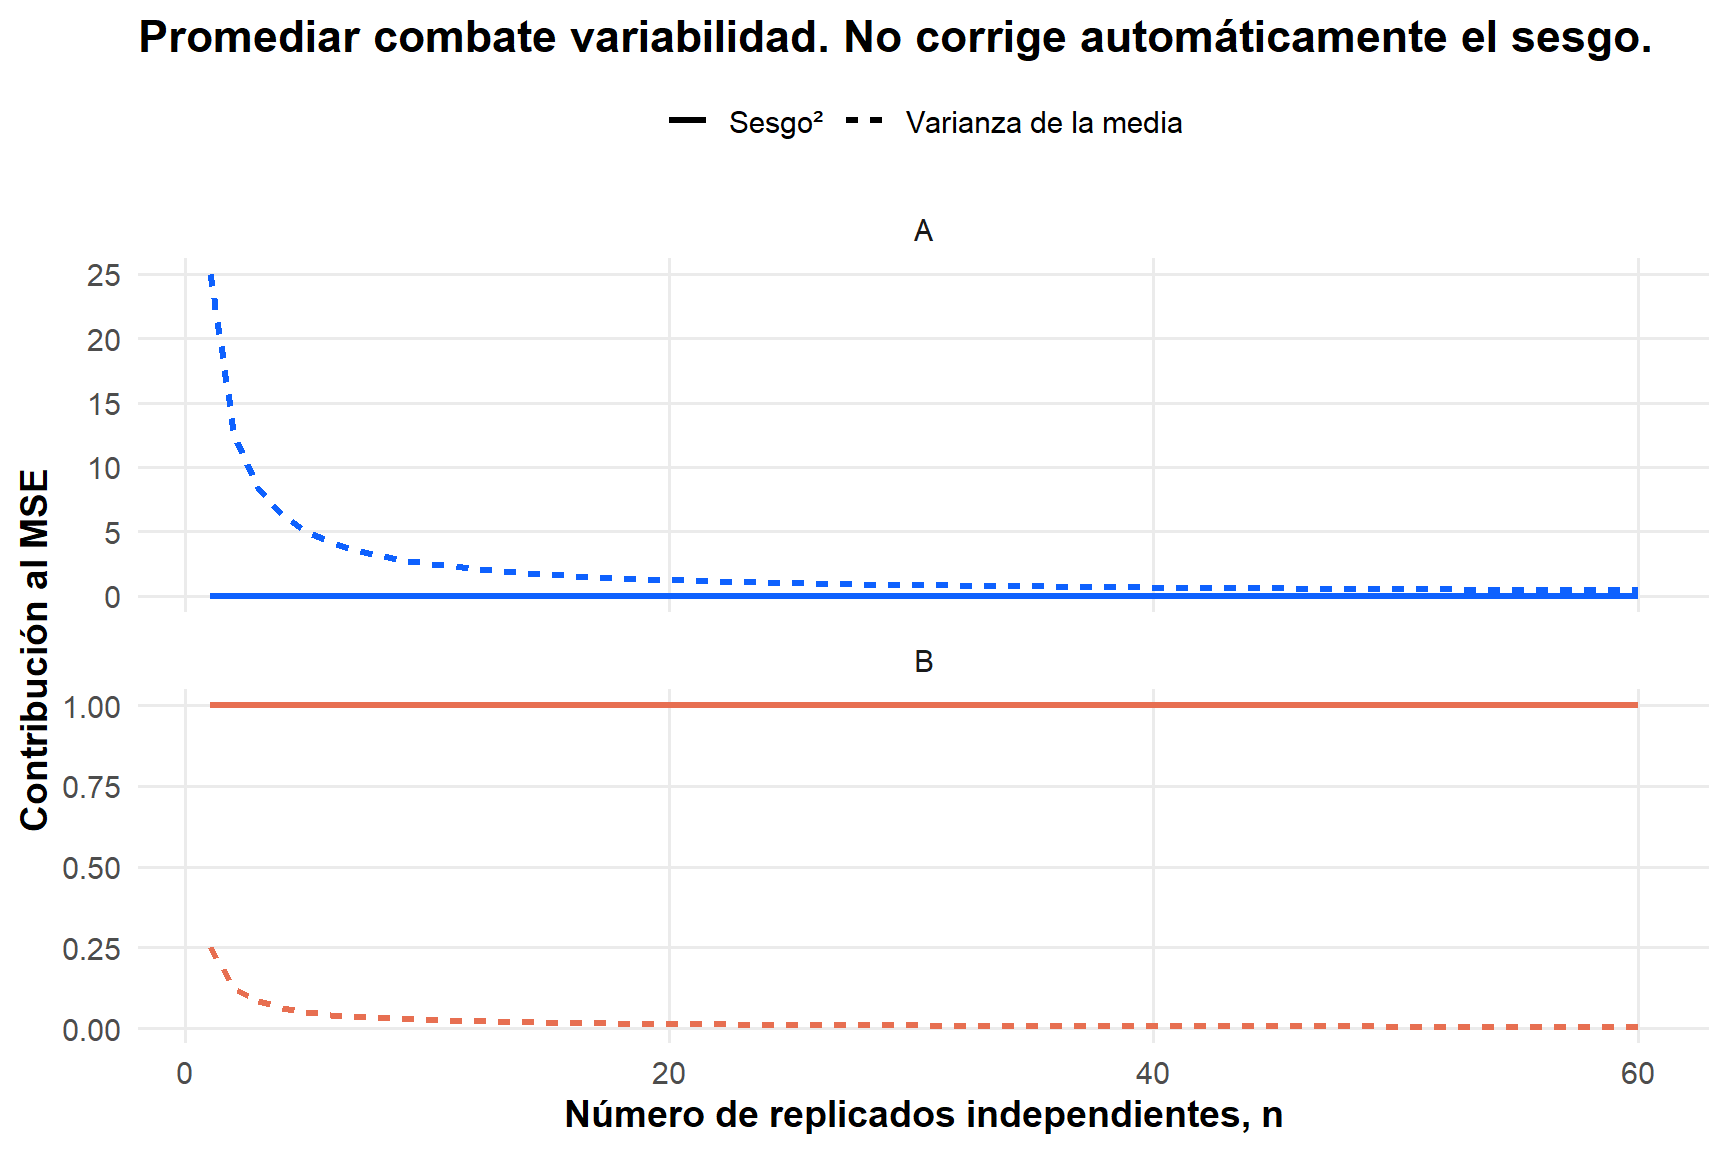
donde $N$ indica una distribución normal; el primer término dentro del paréntesis, $\theta+b$, es el centro de esa distribución, y el segundo, $\sigma^2/n$, es su varianza. Si esta notación no te resulta familiar, lo importante es la consecuencia: **al promediar replicados disminuye la variabilidad del promedio, pero el sesgo sistemático no desaparece por arte de magia.**
El sesgo de la media sigue siendo $b$:
$$
\operatorname{Bias}(\bar X_n)=b,
$$
pero su varianza disminuye:
$$
\operatorname{Var}(\bar X_n)=\frac{\sigma^2}{n}.
$$
::: aside
¿A dónde tiende esta varianza cuando $n \rightarrow \infty$?
:::
Por tanto,
$$
\boxed{
\operatorname{MSE}(\bar X_n)=b^2+\frac{\sigma^2}{n}
}
$$
y
$$
\boxed{
\operatorname{RMSE}(\bar X_n)=
\sqrt{b^2+\frac{\sigma^2}{n}}
}.
$$
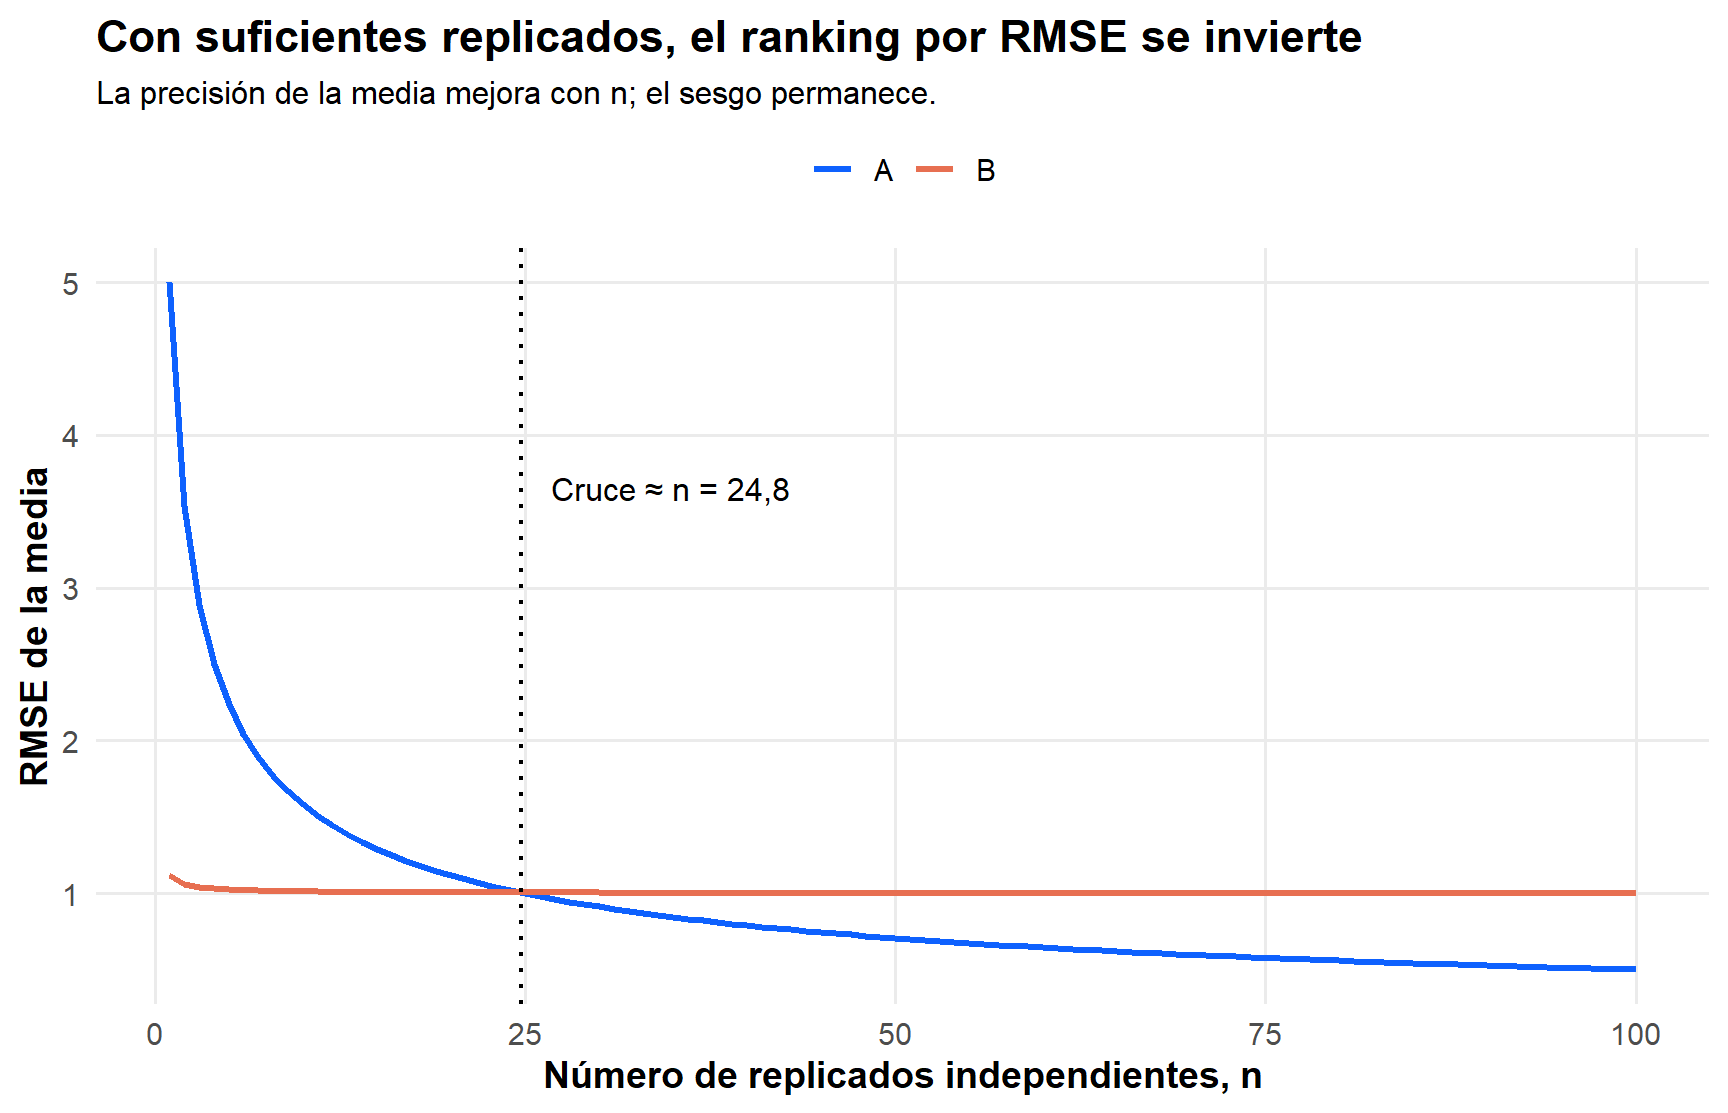
Esto tiene una consecuencia que no siempre es intuitiva: **aumentar el número de replicados reduce la contribución de la imprecisión, pero no elimina el sesgo**.
```{r}
#| label: fig-rmse-n
#| fig-cap: "RMSE teórico de la media de n determinaciones independientes para A y B. El ranking bajo este criterio cambia con n."
#| fig-width: 9
#| fig-height: 5.8
n <- 1:100

rmse_n <- do.call(rbind, lapply(seq_len(nrow(procedimientos)), function(i) {
  data.frame(
    n = n,
    rmse = sqrt(procedimientos$sesgo[i]^2 + procedimientos$sd[i]^2 / n),
    procedimiento = procedimientos$procedimiento[i]
  )
}))

n_cruce <- (procedimientos$sd[1]^2 - procedimientos$sd[2]^2) /
  (procedimientos$sesgo[2]^2 - procedimientos$sesgo[1]^2)

ggplot(rmse_n, aes(n, rmse, color = procedimiento)) +
  geom_line(linewidth = 1.2) +
  scale_color_manual(values = colores_proc) +
  geom_vline(xintercept = n_cruce, linetype = 3, linewidth = 0.8) +
  annotate("text", x = n_cruce + 2, y = max(rmse_n$rmse) * 0.73,
           label = paste0("Cruce ≈ n = ", fmt(n_cruce, 1)), hjust = 0, size = 4.2) +
  labs(
    title = "Con suficientes replicados, el ranking por RMSE se invierte",
    subtitle = "La precisión de la media mejora con n; el sesgo permanece.",
    x = "Número de replicados independientes, n",
    y = "RMSE de la media",
    color = NULL
  ) +
  tema_analytical
```
Igualando los MSE de ambos procedimientos,
$$
0^2+\frac{5^2}{n}
=
1^2+\frac{0.5^2}{n},
$$
obtenemos
$$
n=24.75.
$$
Como $n$ debe ser entero, alrededor de 25 replicados aparece el cambio de orden bajo RMSE.
Fíjate:
Con $n=1$:
$$
RMSE_A=5,
\qquad
RMSE_B\approx1.12.
$$
Con $n=25$:
$$
RMSE_A=1,
\qquad
RMSE_B\approx1.005.
$$
A partir de ahí, A comienza a tener menor RMSE.
Esto **no demuestra que la exactitud haya cambiado de naturaleza**. Demuestra que el ranking depende también de qué entendemos por "resultado". No es lo mismo comparar una determinación individual que el promedio de 25 determinaciones.
Y, por supuesto, en un método real tampoco podemos asumir sin justificación que 25 replicados son independientes, que el sesgo permanece constante, que la varianza es estable o que hacer 25 determinaciones tiene un costo aceptable. El ejemplo sirve para revelar la estructura del problema, no para prescribir un diseño experimental.
# Otra forma de verlo: el sesgo no desaparece por promediar
```{r}
#| label: fig-componentes-mse
#| fig-cap: "Contribuciones al MSE de la media. La componente de varianza disminuye con n; el sesgo al cuadrado permanece constante."
#| fig-width: 9
#| fig-height: 6
n2 <- 1:60

comp <- do.call(rbind, lapply(seq_len(nrow(procedimientos)), function(i) {
  rbind(
    data.frame(
      n = n2,
      contribucion = procedimientos$sd[i]^2 / n2,
      componente = "Varianza de la media",
      procedimiento = procedimientos$procedimiento[i]
    ),
    data.frame(
      n = n2,
      contribucion = rep(procedimientos$sesgo[i]^2, length(n2)),
      componente = "Sesgo²",
      procedimiento = procedimientos$procedimiento[i]
    )
  )
}))

ggplot(comp, aes(n, contribucion, linetype = componente, color = procedimiento)) +
  geom_line(linewidth = 1.1) +
  scale_color_manual(values = colores_proc, guide = "none") +
  facet_wrap(~procedimiento, scales = "free_y", ncol = 1) +
  labs(
    title = "Promediar combate variabilidad. No corrige automáticamente el sesgo.",
    x = "Número de replicados independientes, n",
    y = "Contribución al MSE",
    linetype = NULL
  ) +
  tema_analytical
```
Ésta es una de las razones por las que el conflicto entre veracidad y precisión no puede reducirse a decir que "ambas forman la exactitud" y dar por terminado el problema.
# ¿Y la incertidumbre de medición?
Llegados a este punto aparece una pregunta bastante razonable: **¿no tenemos ya la incertidumbre de medición para expresar cuantitativamente cuán confiable es un resultado?**
Sí, pero responde a otra pregunta. La incertidumbre caracteriza la dispersión de los valores que pueden atribuirse razonablemente al mensurando a partir de la información disponible; no es simplemente un nuevo nombre para la exactitud ni un índice que nos permita reemplazar sesgo y precisión por una sola cifra.
El GUM distingue explícitamente entre error e incertidumbre. Las contribuciones al error pueden estar asociadas a efectos aleatorios o sistemáticos; los efectos sistemáticos reconocidos se corrigen cuando corresponde y las incertidumbres asociadas a las cantidades de entrada y a las correcciones se propagan en el modelo [@JCGM100-2008].
Más importante aún: una incertidumbre pequeña no garantiza por sí sola que el error del resultado sea pequeño. Puede existir un efecto sistemático relevante que no haya sido reconocido [@JCGM100-2008].
ISO 21748 hace una distinción especialmente útil para este artículo: **repetibilidad, reproducibilidad y sesgo caracterizan el desempeño del proceso de medición**, mientras que la incertidumbre se refiere a resultados individuales [@ISO21748-2017].
La misma norma permite utilizar información de precisión y veracidad procedente de estudios de desempeño para evaluar incertidumbre, pero eso no convierte incertidumbre y exactitud en sinónimos [@ISO21748-2017].
## ¿Qué ocurre si conocemos y corregimos el sesgo?
Supongamos que el sesgo de B ha sido estimado de manera adecuada y existe fundamento metrológico para aplicar una corrección.
No sería correcto decir simplemente: "restamos 1 y el problema desapareció".
La corrección se basa en conocimiento imperfecto. La estimación del sesgo tiene incertidumbre y, cuando esa incertidumbre no es despreciable, debe considerarse en la evaluación correspondiente [@ISO21748-2017].
Además, **la incertidumbre asociada a la corrección no se transforma en precisión**. Precisión sigue describiendo la dispersión de resultados bajo condiciones especificadas.
Por eso tampoco es correcto tomar, sin más,
$$
\sqrt{s^2+u(b)^2}
$$
y llamarlo "exactitud" o "precisión global". Una expresión de ese tipo puede aparecer dentro de un modelo de incertidumbre concreto, pero su interpretación depende del modelo y de las fuentes incluidas.
# ¿Qué dicen realmente VIM e ISO 5725 sobre la exactitud?
Hasta ahora hemos construido el problema desde los resultados. Veamos ahora qué ocurre cuando volvemos a las definiciones metrológicas.
## VIM 3: exactitud no es una magnitud
El Vocabulario Internacional de Metrología, VIM 3, define *measurement accuracy* como la cercanía entre un valor medido y un valor verdadero del mensurando. Su Nota 1 señala que el concepto de exactitud de medición **no es una magnitud y no recibe un valor numérico**. Sin embargo, la misma nota añade que una medición se considera más exacta cuando ofrece un error de medición menor [@JCGM200-2012].
Es una formulación interesante: la exactitud no recibe un valor numérico, pero el vocabulario permite establecer comparaciones de "más exacto" y "menos exacto" mediante el error.
El VIM 3 también advierte que *accuracy* no debe utilizarse como sinónimo de *trueness* ni de *precision*, aunque está relacionada con ambas [@JCGM200-2012].
## ISO 5725: exactitud como veracidad + precisión
ISO 5725-1:2023 utiliza el término general *accuracy* para referirse conjuntamente a veracidad y precisión. La propia introducción explica que el concepto pretende considerar el sesgo respecto de un valor de referencia debido tanto a efectos sistemáticos como aleatorios [@ISO5725-1-2023].
Pero cuando la norma operacionaliza esas ideas, trabaja con sus componentes: la veracidad puede investigarse mediante sesgo y la precisión mediante desviaciones estándar bajo condiciones especificadas [@ISO5725-1-2023; @ISO5725-4-2020].
Esto es importante para nuestra pregunta: **describir cuantitativamente los componentes no implica automáticamente disponer de una única cantidad escalar de exactitud**.
::: aside
**Escalar** = un número. No una matriz o un vector; sino un simple y ordinario número.
:::
## El borrador de VIM 4 introduce algunas novedades
Existe además un *Committee Draft* de 2021 de la cuarta edición del VIM. Debe leerse como lo que es —un borrador de trabajo, no como sustituto vigente del VIM 3—, pero su redacción resulta conceptualmente interesante.
En la entrada 3.15 señala que, dependiendo del contexto, la exactitud a veces se considera una cantidad que puede evaluarse. Para un procedimiento de medición indica que la exactitud suele conocerse y reportarse cuantitativamente, a veces en términos de **sesgo y desviación estándar** [@VIM4-CD-2021].
Obsérvese el detalle: **sesgo y desviación estándar**.
Dos cantidades.
No aparece una regla universal que diga cuánto de una puede intercambiarse por cuánto de la otra para declarar que un procedimiento es globalmente "más exacto".
Ese vacío no es necesariamente un defecto. Puede ser simplemente una señal de que estamos intentando pedirle a una palabra más de lo que puede proporcionar.
# Entonces, ¿cuál de los dos procedimientos elegirías?
Volvamos a nuestros procedimientos.
A:
$$
b_A=0, \qquad \sigma_A=5.
$$
B:
$$
b_B=1, \qquad \sigma_B=0.5.
$$
Si tu criterio es RMSE de una determinación individual, B es claramente preferible.
Si el resultado es la media de suficientes replicados independientes, ese ranking puede invertirse bajo el mismo criterio.
Si el sesgo puede estimarse y corregirse de forma metrológicamente defendible, el problema cambia otra vez.
En otras palabras:
> **La estadística puede describir y cuantificar el compromiso. No puede decidir qué compromiso es aceptable sin información sobre el propósito de la medición.**
# Lo que sí podemos afirmar
De este ejemplo salen, al menos, cinco conclusiones.
1. **Exactitud no es sinónimo de veracidad.** Un procedimiento sin sesgo puede ser muy impreciso.
2. **Exactitud tampoco es sinónimo de precisión.** Un procedimiento extremadamente preciso puede presentar un sesgo relevante.
3. **Sesgo y precisión pueden evaluarse cuantitativamente sin que eso produzca automáticamente un único índice de exactitud.**
4. **MSE y RMSE permiten combinar sesgo y varianza bajo un criterio concreto**, pero no son por ello una definición metrológica universal de exactitud.
5. **Cuando un procedimiento gana en veracidad y otro en precisión, la pregunta "¿cuál es más exacto?" está incompleta si no especificamos para qué queremos medir y qué consecuencias tienen los errores.**
# Una última pregunta
Los conocidos diagramas de exactitud y precisión son útiles para enseñar conceptos.
El problema comienza cuando dejamos el dibujo y volvemos al laboratorio.
Allí no siempre tenemos un procedimiento "malo en todo" y otro "bueno en todo". Muchas decisiones reales son intercambios: más precisión a cambio de cierto sesgo, menor incertidumbre a cambio de mayor costo, más replicados a cambio de tiempo, menor límite de cuantificación a cambio de un procedimiento más complejo.
En esos casos, una clasificación simple puede ocultar precisamente lo que necesitamos discutir.
Quizás el problema no sea que no podamos ponerle un número a la exactitud.
**Quizás el problema sea creer que existe un único número capaz de decirnos qué significa medir mejor.**
Sería cómodo tener una función `EXACTITUD()` que devolviera un número y nos ahorrara la discusión. Por desgracia —o por suerte para quienes todavía creemos que la química importa—, el laboratorio suele exigir algo más de criterio.
Y la próxima vez que veas en redes sociales uno de esos típicos gráficos de dardos alrededor de un valor objetivo, acompañado de la pregunta:
«¿Cuál es más exacto?»
ya sabes qué responder:
**Depende**.
Y si después de leer todo esto esa respuesta te parece mejor que antes, eres de los míos.
# Referencias
::: {#refs}
:::